Idea-Forge与Idea-Radar
背景
机缘巧合之下入职了一家单位,有大规模的自部署的AI算力,给员工配备了近乎无限的Token(1. 模型均为开源模型且与主流平台相差两个月左右,2. 在降本增效且各大公司均在要求 产物/Token 比的背景下这必然不会持久),在此背景下,如何快速的将无限的Token转化成有价值的知识/代码/工程,就变为了一个亟待解决的课题。
在此背景下诞生了两个项目Idea-Forge(想法锻造器)与Idea-Radar(想法雷达)。
Idea-Forge是一个Super-agent借鉴了Super-agent 设计探索:迈向更自主的 Agent 系统的思想。用于并行的调度一些会话,尽量少的在人工干预下,进行长任务执行。由AI主导将一个想法落地成一个可执行的项目。
有了想法锻造器不能没有想法,于是想法雷达Idea-Radar就成了第一个Idea-Forge的产物。可以理解为一个信息聚合器,从互联网平台(主要是Github、HackNews、Reddit等),获取一些想法和项目(大家都在做什么创新/创业项目,有什么有趣的想法或者需求)。可行性如何,有什么业务价值等。
下文将简单介绍一下这两个项目以及Idea-Radar的锻造过程。
Idea-Forge
输入一个 Idea,只在五个闸口做人工审核,其余由多个 agent 无人值守完成,产出可运行、分版本的软件增量,并保持可向生产演进。
idea-forge 是一个 Agent Skill(SKILL.md 格式,可用于 Claude Code、GitHub Copilot CLI 等支持 skill 的 agent),用于技术探索和 Idea 的落地实现。它由三部分组成:
- 编排者(
SKILL.md):薄调度器,只读状态和摘要,按forge.py next的指令行动。 - 确定性状态机(
scripts/forge.py):管理阶段、闸口、任务 DAG、预算和 git 操作,不依赖 LLM 记忆。 - 角色化 workers(
references/roles/):researcher / architect / designer / planner / implementer / reviewer / verifier / critic,每次全新上下文;另有独立于主流程的 watchdog(见下)。
适用场景
适合:想把一个技术想法或设计思路快速落地为可运行、可演进的软件,并希望人只在关键决策点介入。
不适合:需要大量实时人机交互的探索。每个里程碑范围刻意保持小,但质量标准是生产级(测试、错误处理、清晰边界),以便下一个版本在其上扩展而非重写。
核心流程与五个闸口
1 | flowchart LR |
| 闸口 | 人看什么 | 说明 |
|---|---|---|
| G1 方案 | 一页 packet:选项对比、推荐、首个版本定义、范围裁剪、kill criterion;外加**技术规格 SPEC.md**(技术体系、技术栈、运行宿主环境),缺失则 gate open G1 被拒绝 |
critic 先挑战,最强反对意见写入 packet |
| G2 架构 | 渲染后的架构图 + ARCHITECTURE.md + ADR |
架构图必须用 draw.io 绘制(.drawio 源文件 + 渲染图入库);缺图或未渲染则 gate open G2 被拒绝 |
| G3 界面 | 以 prototype/index.html 为入口、可交互跳转的完整原型(不提供截图);原型按生产标准输出,页面内不含审阅建议、使用说明、异常说明等说明性 UI(说明写在 DESIGN.md/packet);只审一个主平台(传统 Web 仅桌面,移动端仅移动 UI,除非人或技术规格要求多端) |
无 UI 的项目可跳过(除非指定 --ui yes);缺原型或页面链接断裂则 gate open G3 被拒绝 |
| G4 计划 | 里程碑(=可演示版本)与任务表 | plan load 校验依赖环与未知依赖 |
| G5 版本 | verifier 生成的证据:测试、截图、运行步骤、已知缺口 | 每个里程碑一次;通过才发布该版本 |
闸口是状态,不是聊天提问:gate open 将状态置为 waiting_gate,提交并推送、通知人,然后会话结束。闸口之后的任何工作在决策前都不会执行。拒绝必须附带意见,进入修订循环;abort 终止整个运行。
自动裁决与必须上报
- 自动裁决(写入 ledger,Taste 类汇总到下一个 packet):命名、同类库选型、文件布局、次要 UX、测试工具、任务顺序。
- 不自动裁决:改变核心目标或范围裁剪、花钱/外部账号、破坏性操作、密钥、许可证问题、按字面不可能的需求。
Idea Radar
一个本地、单人自用的 Web 应用:点一次「刷新」,从多个公开源抓取项目信号与需求信号,
去重、分轨、打分,产出每轨各 5 条(可展开全部)的候选清单;每条都能回答
① 它是什么 · ② 谁现在就要 · ③ 已有替代品 · ④ 最小实现 · ⑤ 如何验证,
并且能溯源、敢说「未知」。
| 形态 | 本地 Web 应用 · http://127.0.0.1:8765 · 只绑本机 |
| 技术栈 | Python 3.13 + FastAPI + SQLite(WAL)+ 原生 HTML/ES module(无打包器、零 npm 构建) |
| 持久化 | 单个 SQLite 文件 data/radar.db(已 gitignore) |
| 测试 | 1222 passed(离线、零出站;实测 47 秒)· ruff check 全绿 |
| 当前状态 | M1 已完成并通过独立验证,G5 待人类裁决(是否合入 main) |
它解决什么问题
调研阶段(.forge/research/)的结论是:真正的死因不是「缺点子」,是「存下来就再也没打开过」。
所以本项目不做”又一个 trending 列表”,而是把两类信号分轨呈现、每条可溯源、中文优先、本地、零付费:
| A 轨 · 项目信号 | B 轨 · 需求信号 | |
|---|---|---|
| 回答 | 有什么新鲜、值得研究的技术/创业项目 | 有人在喊缺什么工具 |
| 来源 | Show HN · GitHub 新仓库 · arXiv · HuggingFace | Ask HN(4 条文本 query 命中) |
| 排序分 | 「值得研究」分 | 「现在就做」分 |
| 准入 | 宽松(R2) | 严格(R4) |
两个分数各自独立、绝不合成总分——这是刻意的:单一综合分会让「可动手」被「热度」淹没。
界面(3 个视图)
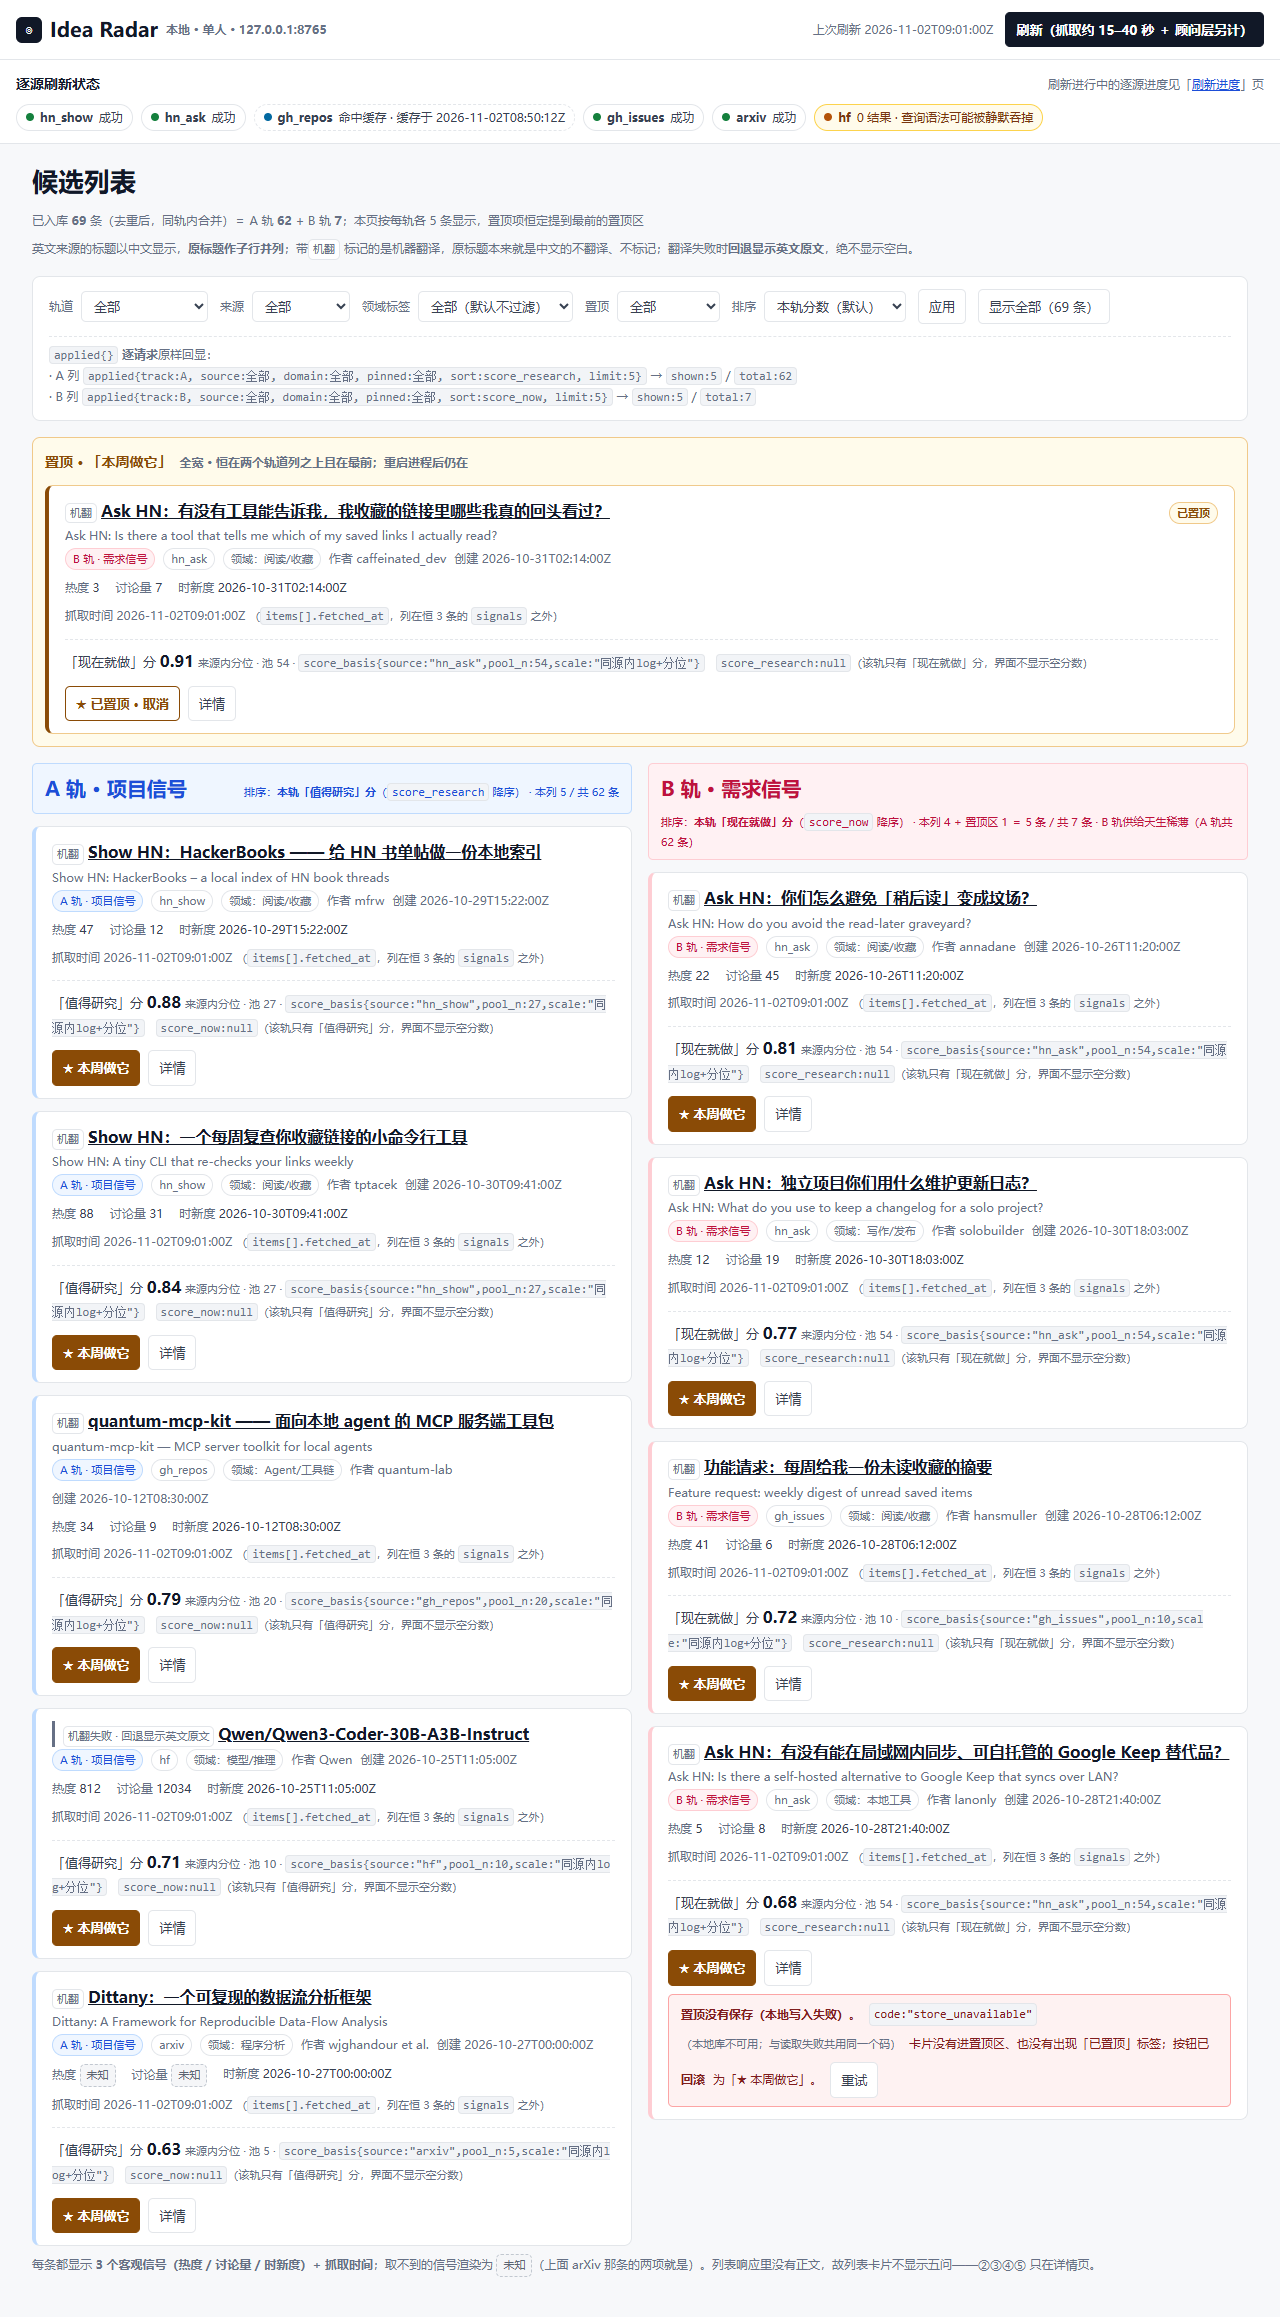
列表页:两轨分列(A 左 / B 右),全宽置顶区恒在最前。默认每轨 5 条,「显示全部」展开为每轨上限 200。
每张卡片:中文标题为主 + 英文原标题作子行(标「机翻」)、领域标签、来源徽标、本轨分数、
3 个客观信号、以及「详情」与「★ 本周做它」两个并列入口。
页面顶部是逐源刷新状态(hn_show / hn_ask / gh_repos / arxiv / hf),每个源的成功/失败与原因都是单独一行的。
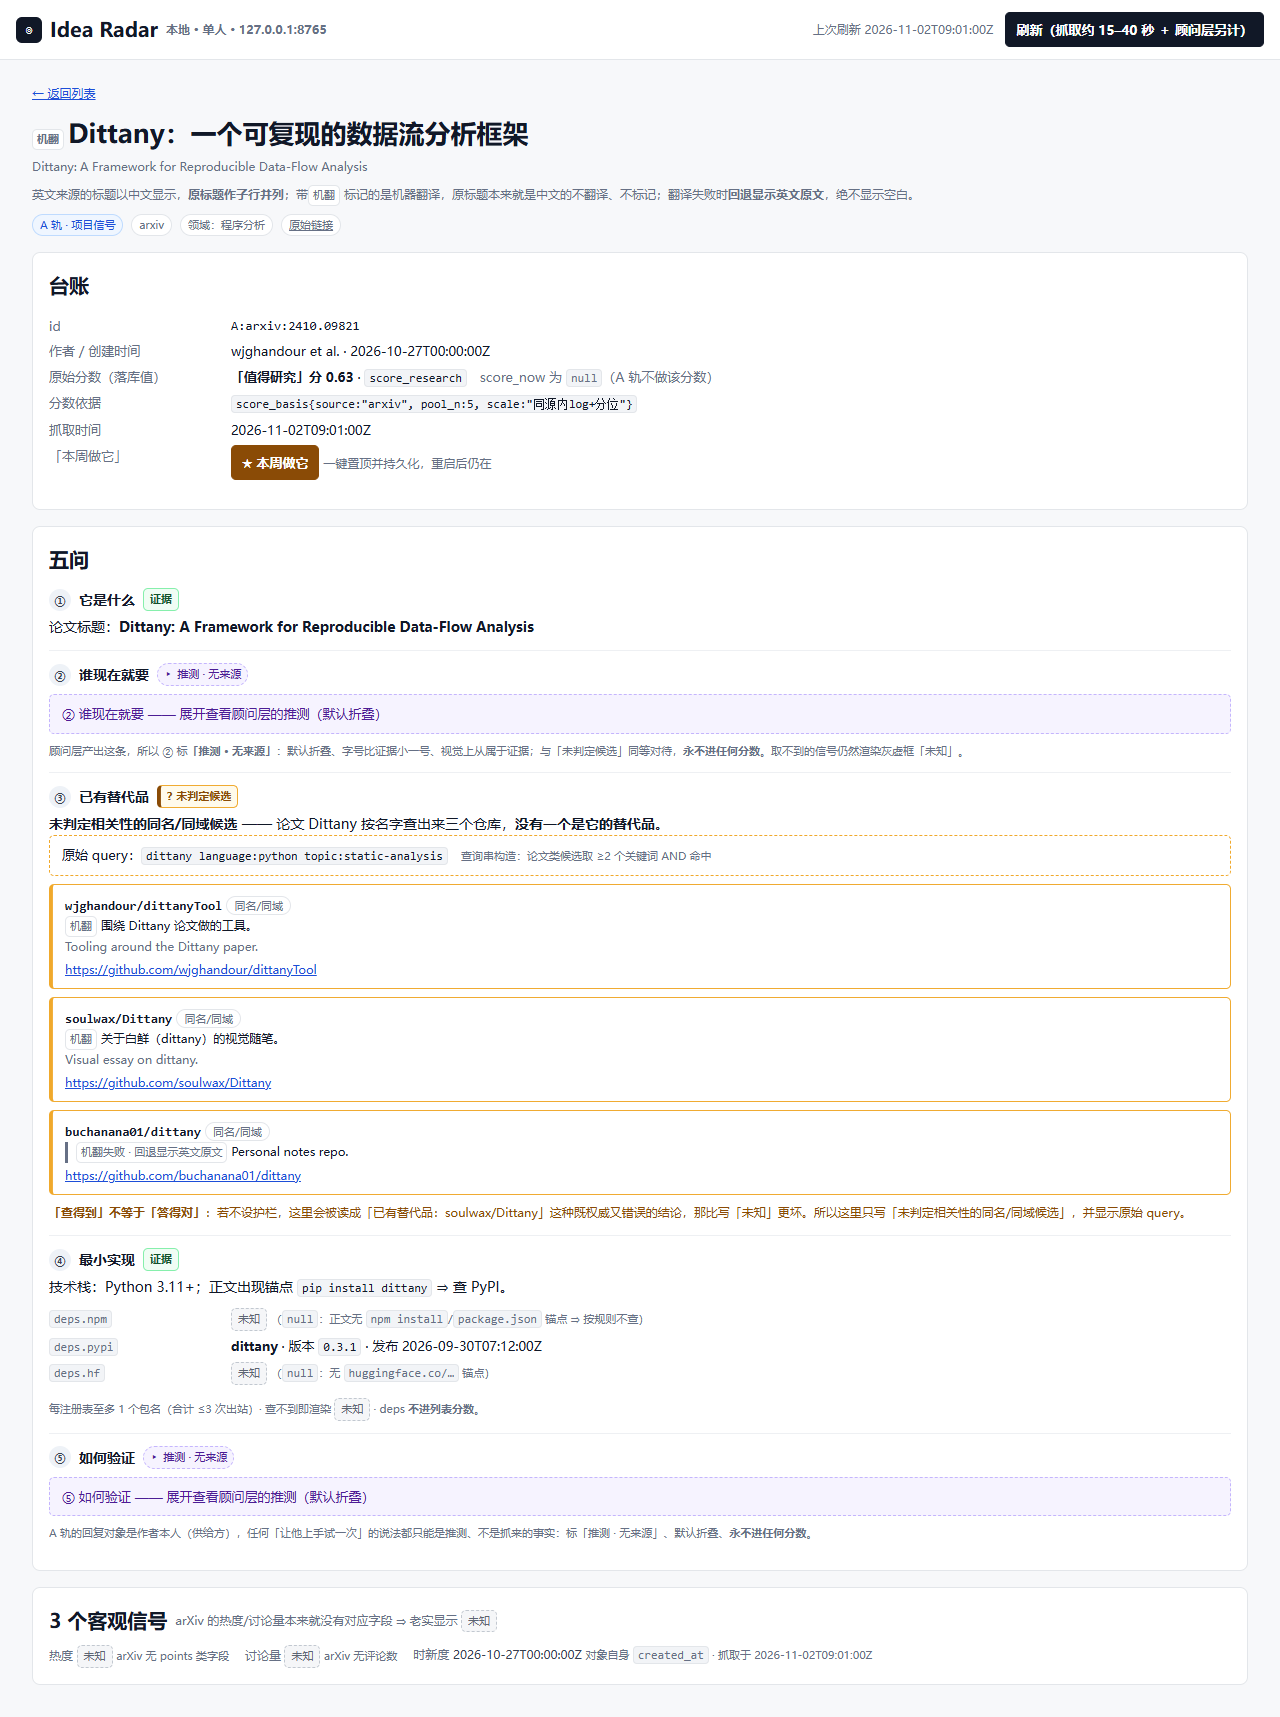
详情页:五问逐条展开,每条字段都带 origin 徽标(见下「诚实性」)。③ 有独立面板显示原始 query、未判定候选 标签与竞品列表;④ 显示 npm / PyPI / HF 的真实端点结果;⑤ 显示原始分数与抓取时间。
另有 4 个错误屏:GitHub 限流 · 本应用自设上限 · 代理不可达 · 0 结果(R7)。
刷新进度:POST /api/refresh 立即返回 202,UI 每秒轮询,逐源状态实时推进。
Idea-Radar的锻造过程
本节将介绍基于
Idea-ForgeSkil 锻造Idea-Radar项目的过程,文章的组织形式偏流水账,可仅关注每节节首的引用部分,会对当节做一个一句话总结,内部的详细过程可略过。
初始录入
初始录入非常简单,只有一个简单的Prompt原始内容如下:
1 | 我计划构建一个应用,用于向我推荐一些创新创业项目,或者新鲜有趣的技术探索类项目。具体操作方式在互联网检索一些必要的热点项目,或者通用型的可通过软件开发实现的具体需求。现在用 idea-forge 把这个想法做出来 |
各个评审闸口
G1 方案设计闸口
执行到 G1 基于
Idea-ForgeSkil,Agent 交付了一些文档以及待决策的事项(基本都带建议,如果为了节省人脑算力,可以简单对方案做评估,通过后批准AI继续执行,按照它的建议即可)。大致内容如下:
需要你决定的事: 要不要按这个方案建这个应用?M1 做多大?以及 5 条具体取舍。
我的建议: 批准(approve-with-notes),M1 = 规则核心 + UI,顾问层进 M2。
打开看
.forge/docs/PROPOSAL.md(v5,先看 §0.1 与 §10) —— 方案全文.forge/research/pilot-five-questions.md—— 最值得看的一份:对真实前 10 条逐条试填五问,逐字段标注「自动可填/只能留空/需 LLM」.forge/gates/G1/critique.md·critique-r2.md·critique-r3.md·critique-r4.md—— 四轮对抗审查(终审判 PASS).forge/research/—— 先行者 / 可行性 / 用户价值三份(含各自的「我无法验证的事」)
三个方案
| A|信号看板 | B|双轨证据台账(= 本方案的 M1) | C|B + 顾问层(本方案的 M2) | |
|---|---|---|---|
| 智能放在哪 | 规则打分 | 规则引擎出事实与分数 | 规则出事实;claude -p 只改写措辞,永不产出 URL |
| 致命问题 | 此形态已被免费开源做烂,差异化归零 | A 轨内容薄(见下) | 非确定性、单次 ≈95k 输入 tokens |
| 成本 | 零 | 零 | 零现金(消耗你已有的 Claude 订阅额度) |
G2 架构审批
老样子和 G1 差不多,同样是先看图,再看待审批事项,大致内容如下:
先看图(这是 G2 的重点,10 分钟)
| 图 | 文件 | 看什么 |
|---|---|---|
| ① 系统上下文 | .forge/docs/diagrams/01-context.drawio.png |
应用与 4 个外部源、代理的关系;P1–P5 约束是否画对 |
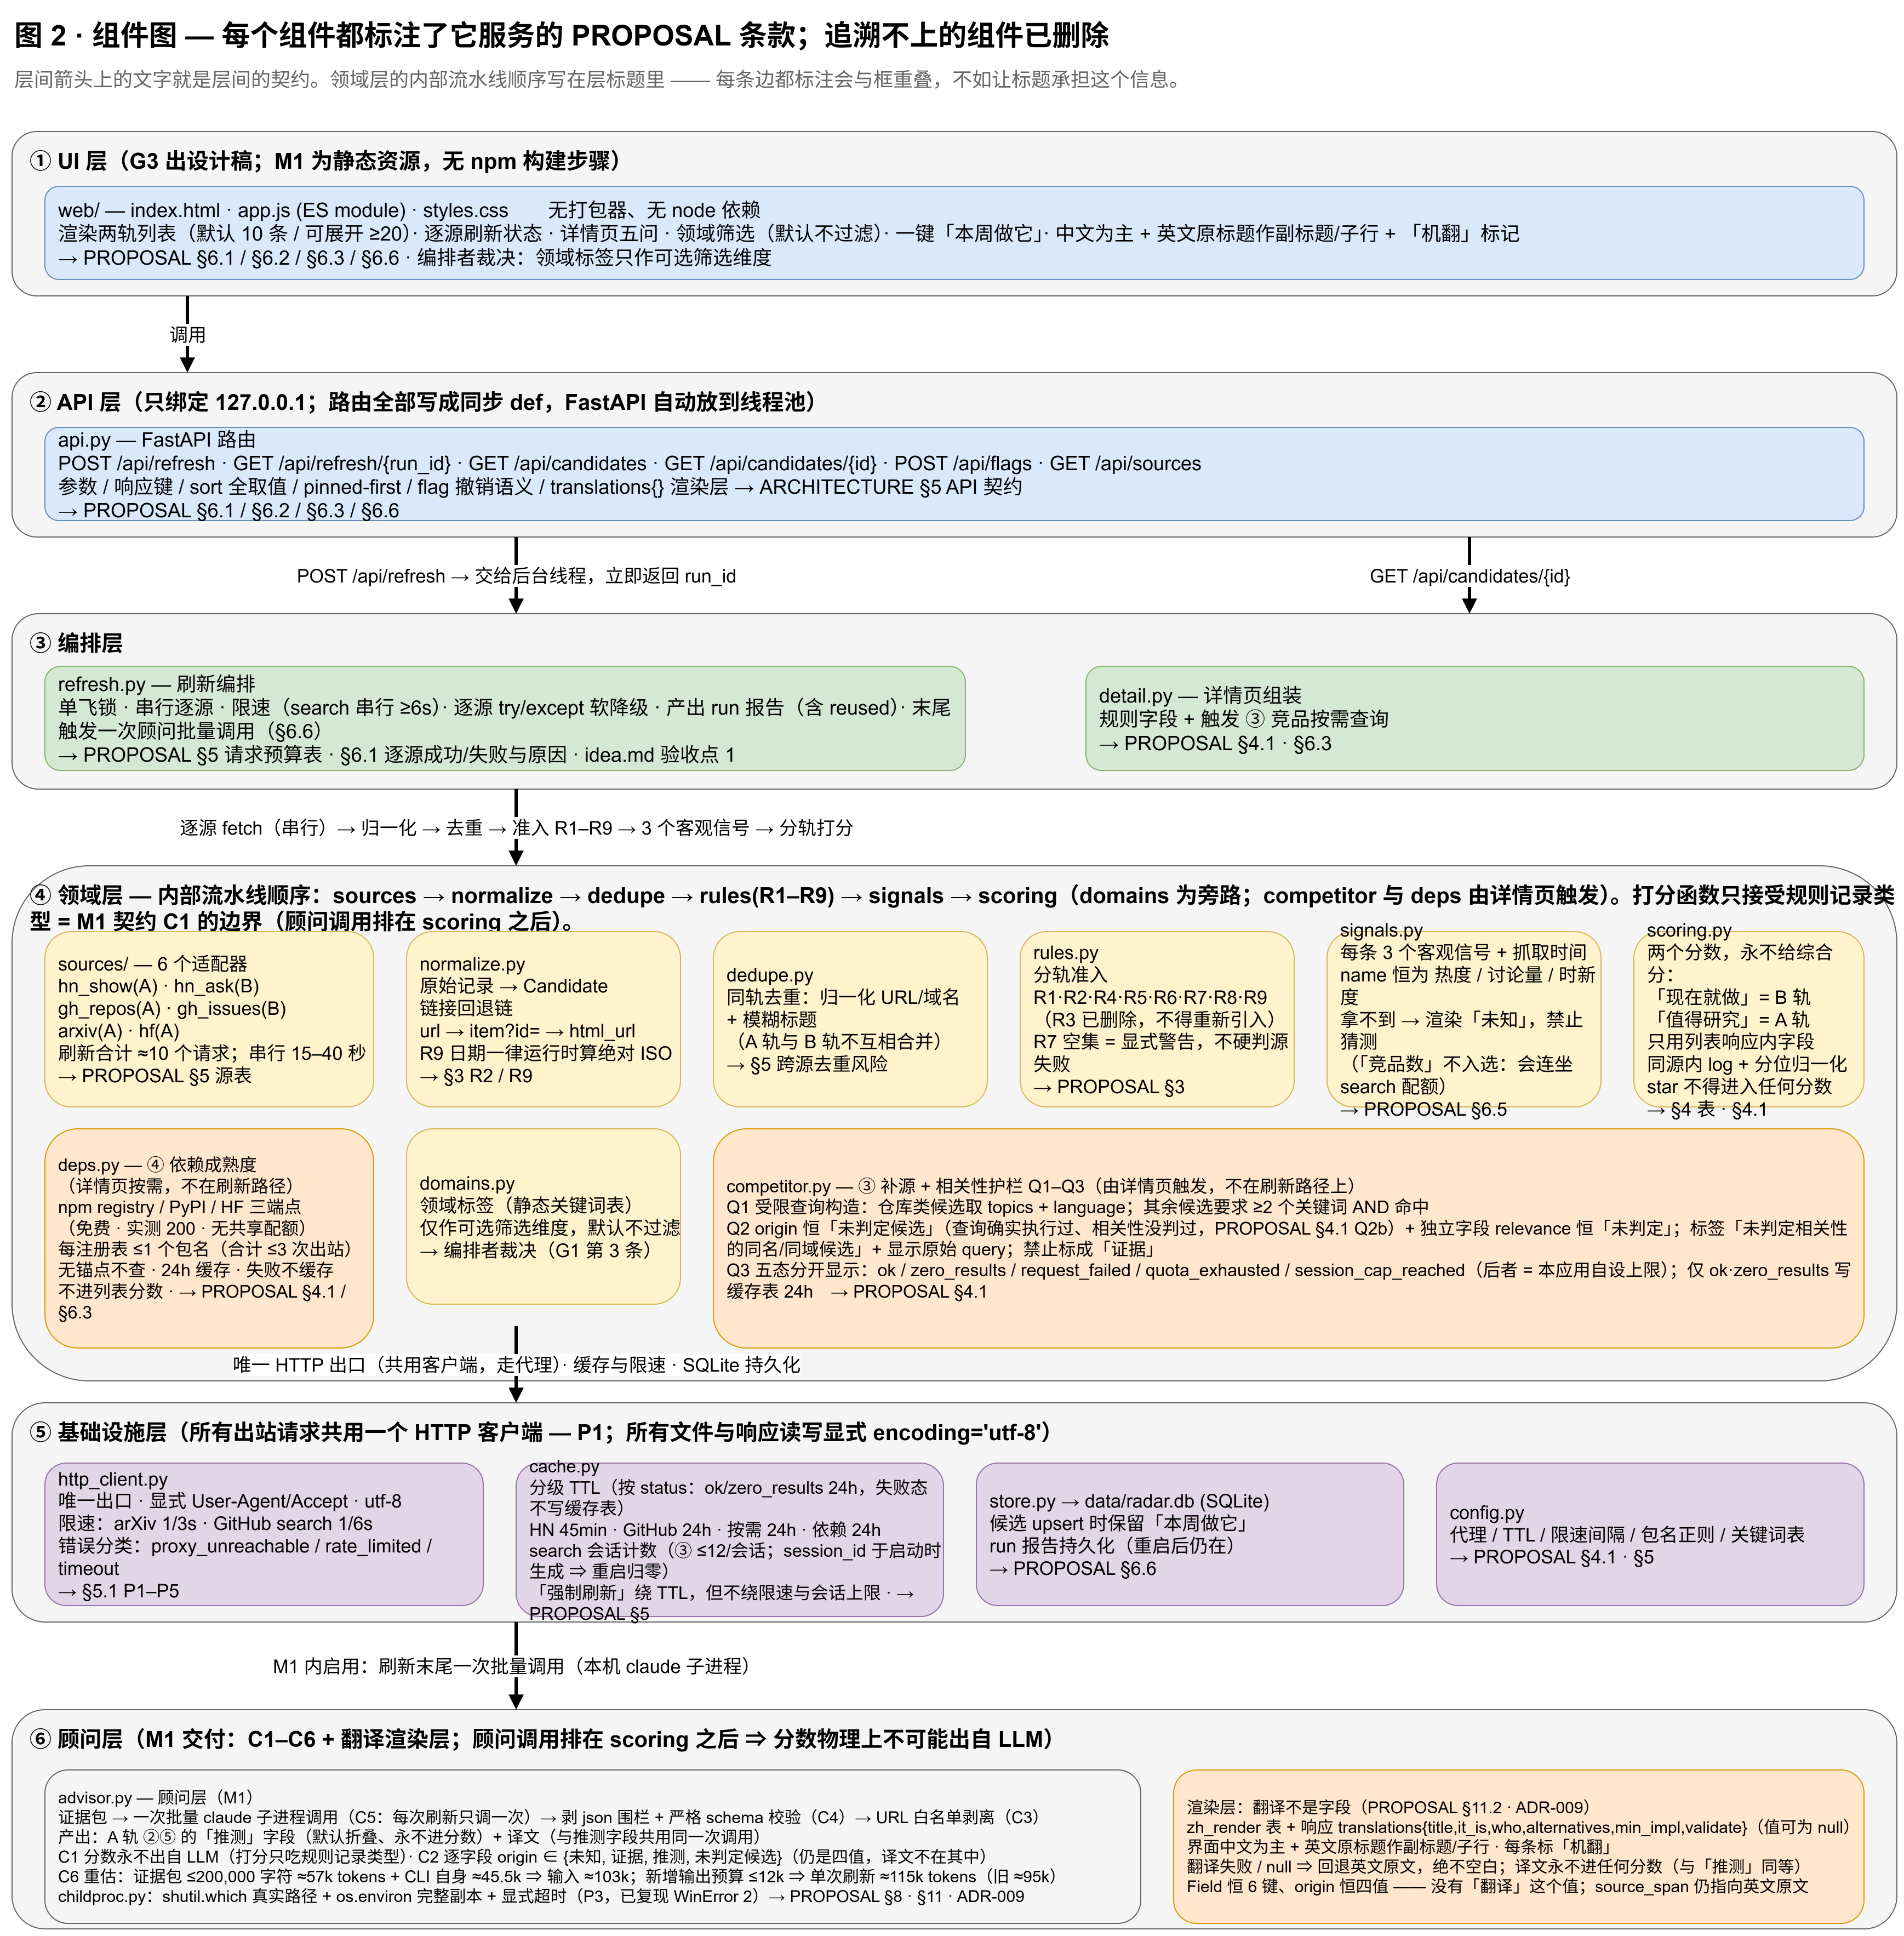
| ② 组件图 | .forge/docs/diagrams/02-components.drawio.png |
每个组件旁标了它服务的 PROPOSAL 条款号——追溯不上的组件已删掉 |
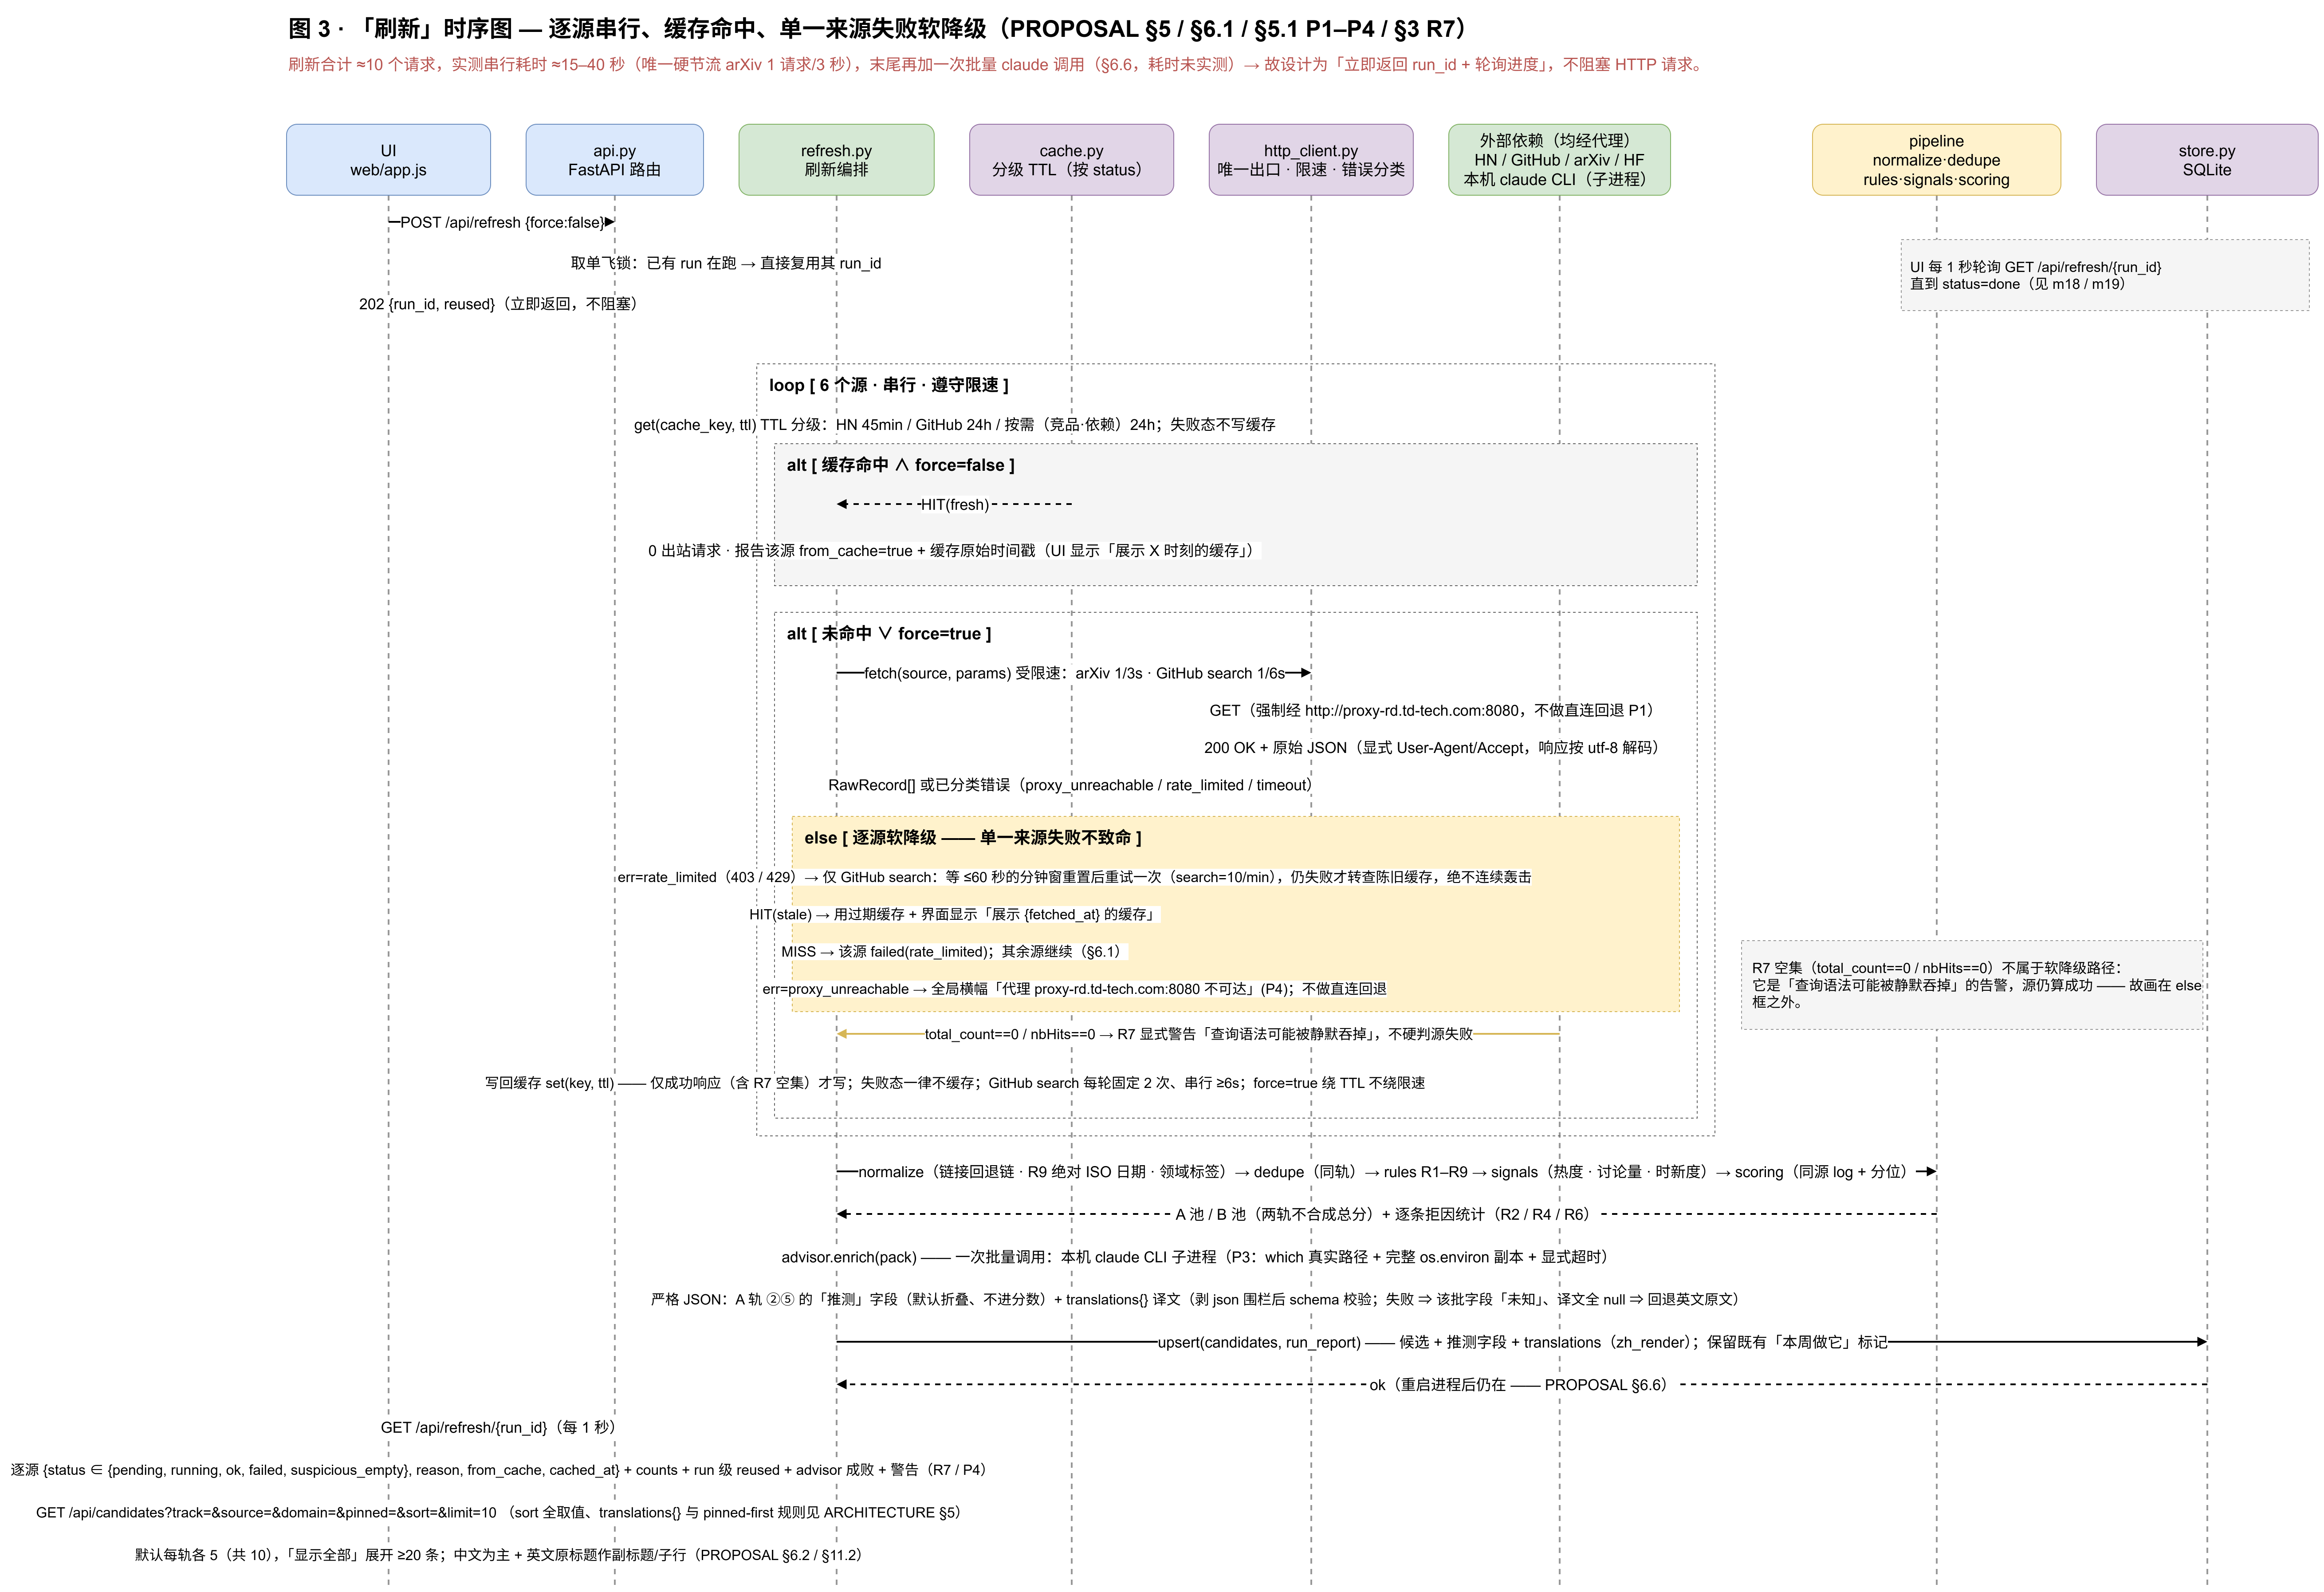
| ③ 刷新时序 | .forge/docs/diagrams/03-refresh-sequence.drawio.png |
逐源串行、缓存命中 vs 未命中、单个源失败软降级、R7 的 0 结果 vs 请求失败分开显示 |
| ④ 竞品查询时序 | .forge/docs/diagrams/04-competitor-sequence.drawio.png |
③「已有替代品」的护栏 Q1–Q3、五态状态机、失败不缓存 |
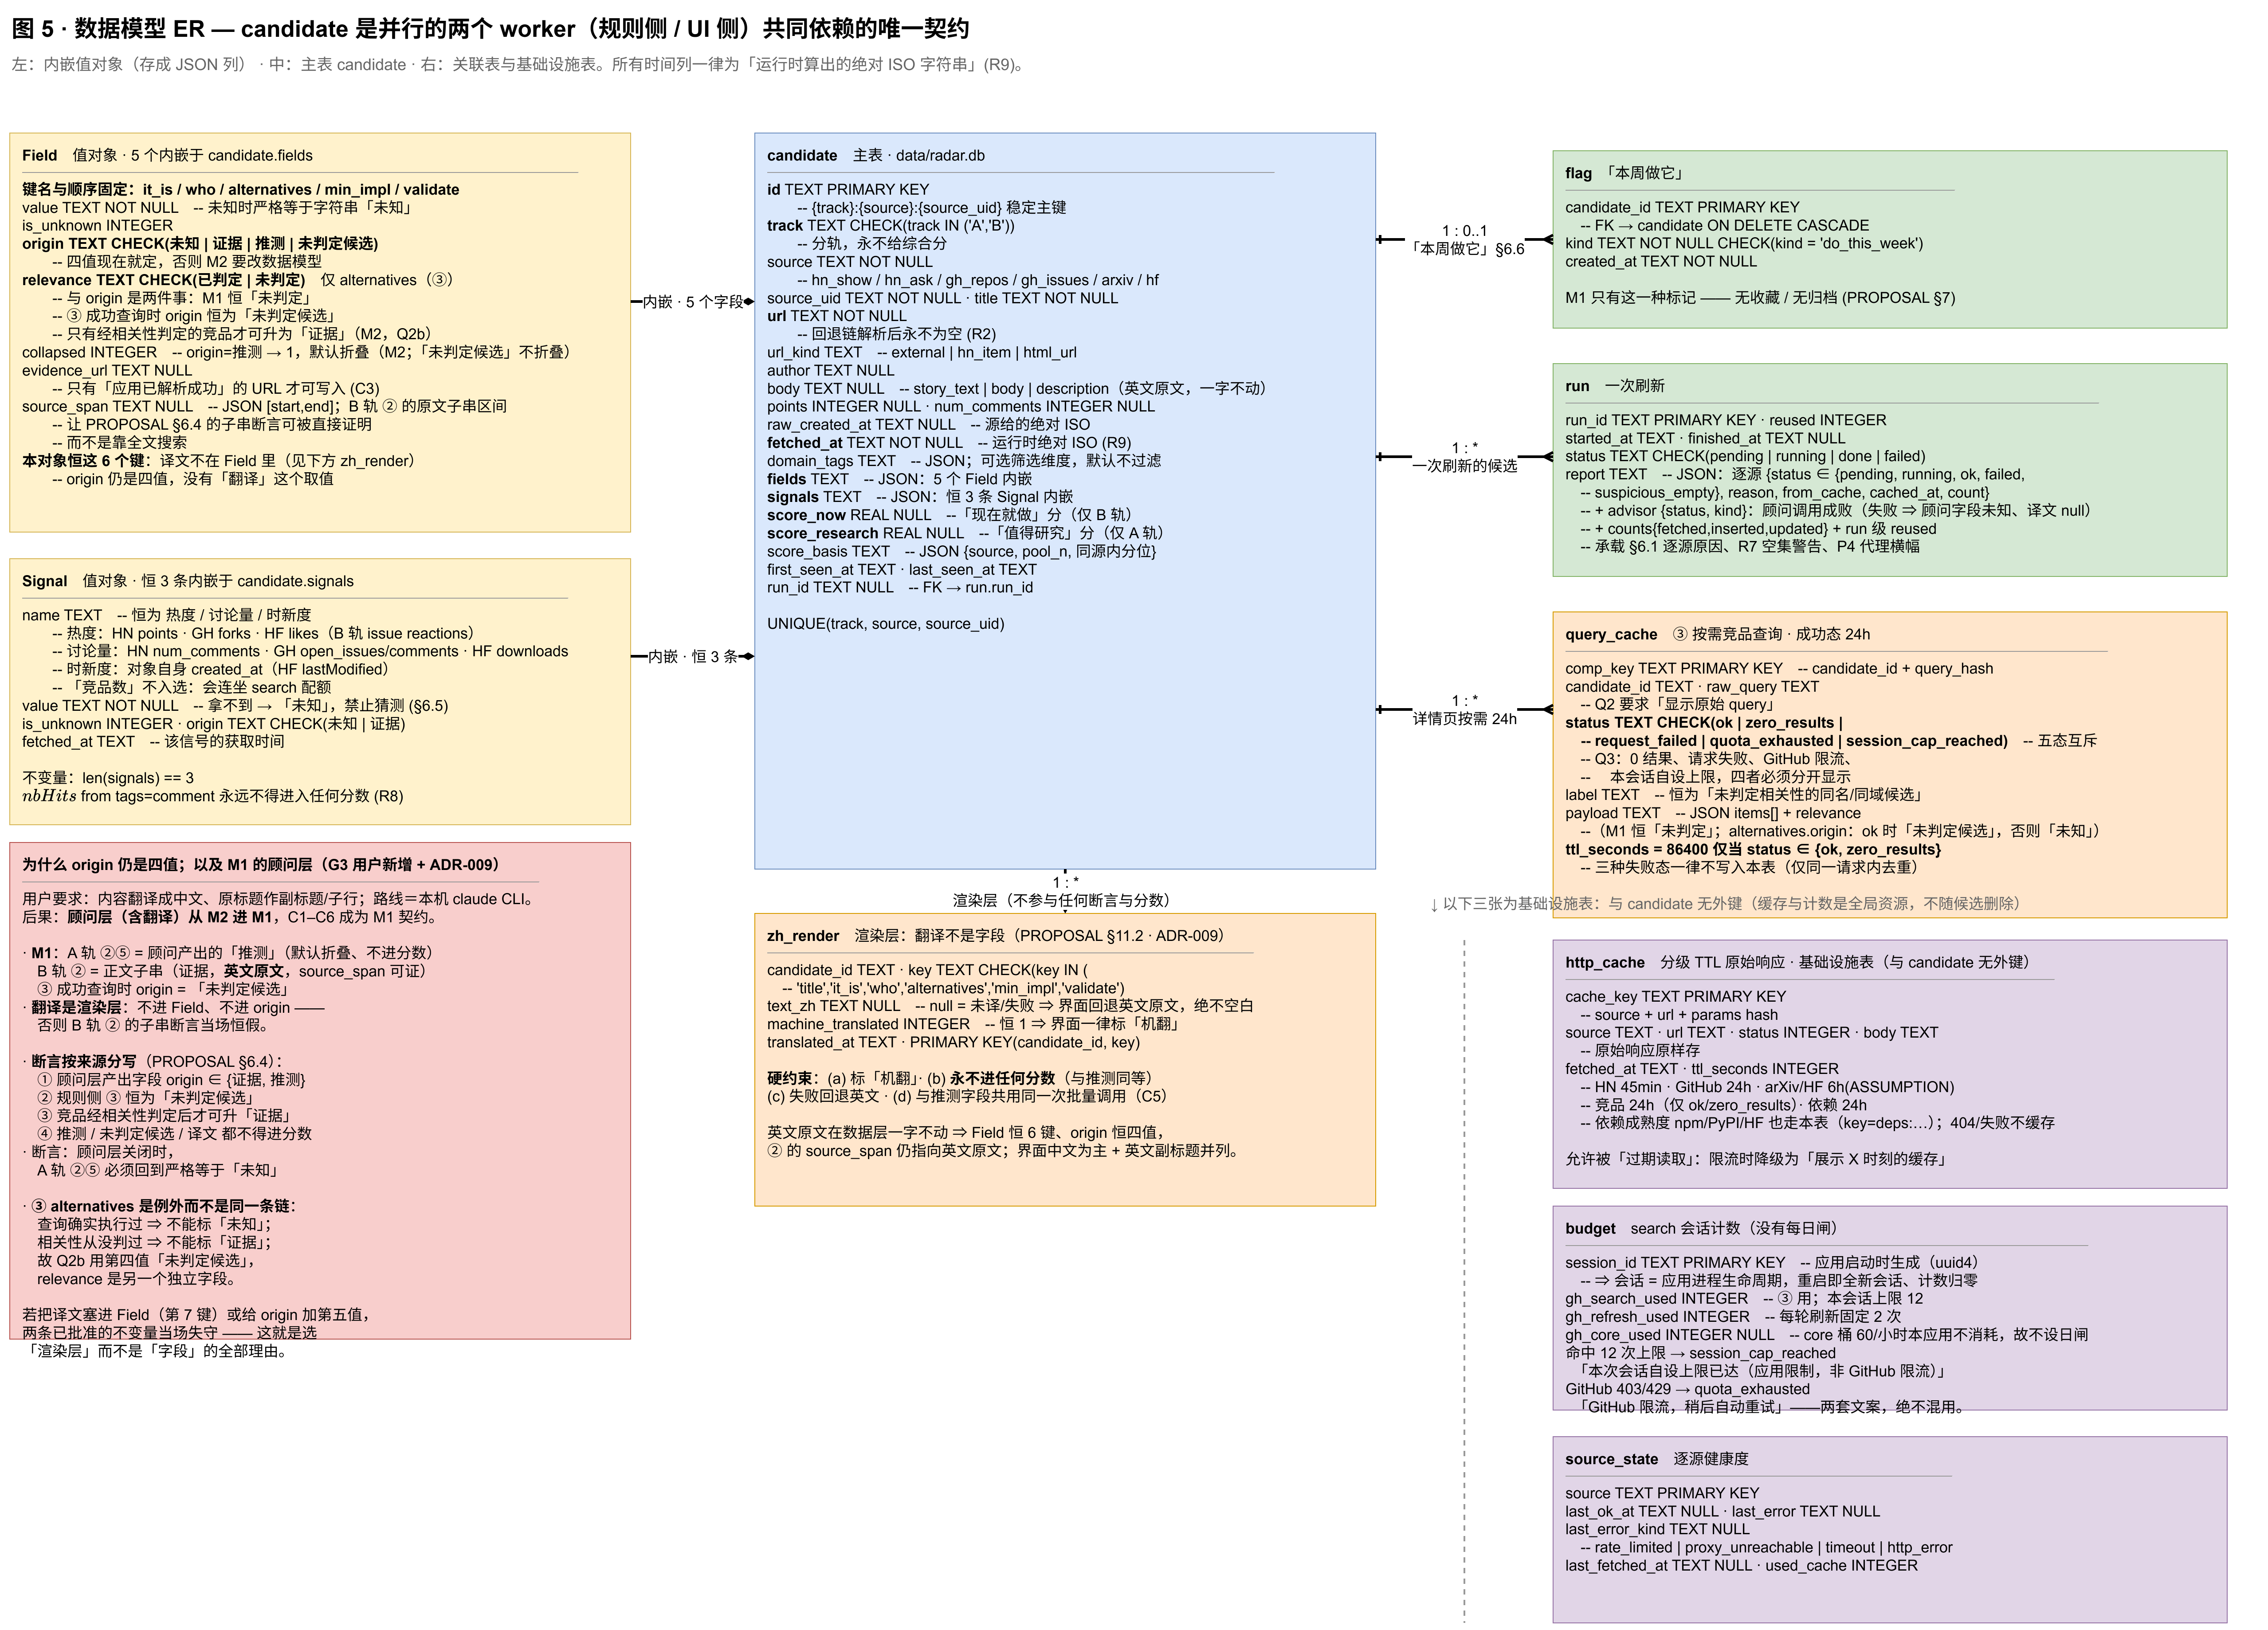
| ⑤ 数据模型 ER | .forge/docs/diagrams/05-data-model.drawio.png |
两轨字段、origin 四值、relevance、3 个信号的不变量 |
(都是 .drawio 源文件 + -s 2 渲染的同名 PNG,3475–5125 px,可放大看。改完请回看 .forge/docs/ARCHITECTURE.md。) |
你要批的是什么(2 分钟能看完)
M1 = 规则核心 + UI(无 LLM):点「刷新」→ 4 个源约 10 个请求(实测 15–40 秒,故设计成”立即返回 run_id + 轮询进度”而非阻塞)
→ 入库 ≥20 条去重候选(默认显示 10、可展开)→ 两轨分列、两个独立分数、无综合分 → 详情页:B 轨五问必答、
A 轨三问、③ 由真实查询得到 → 一键「本周做它」置顶持久化(重启后仍在)。
数据模型已冻结:五问键名 it_is/who/alternatives/min_impl/validate、origin 四值、relevance、source_span(让”②必须是原文子串”这条断言可被证明而非靠全文搜索)、6 条 API 路由的参数/响应键/枚举。
测试策略已映射到 §6 的 6 个验收点;另有 test_replay.py 重放夹具作配额无关的验收证据通道。
系统上下文
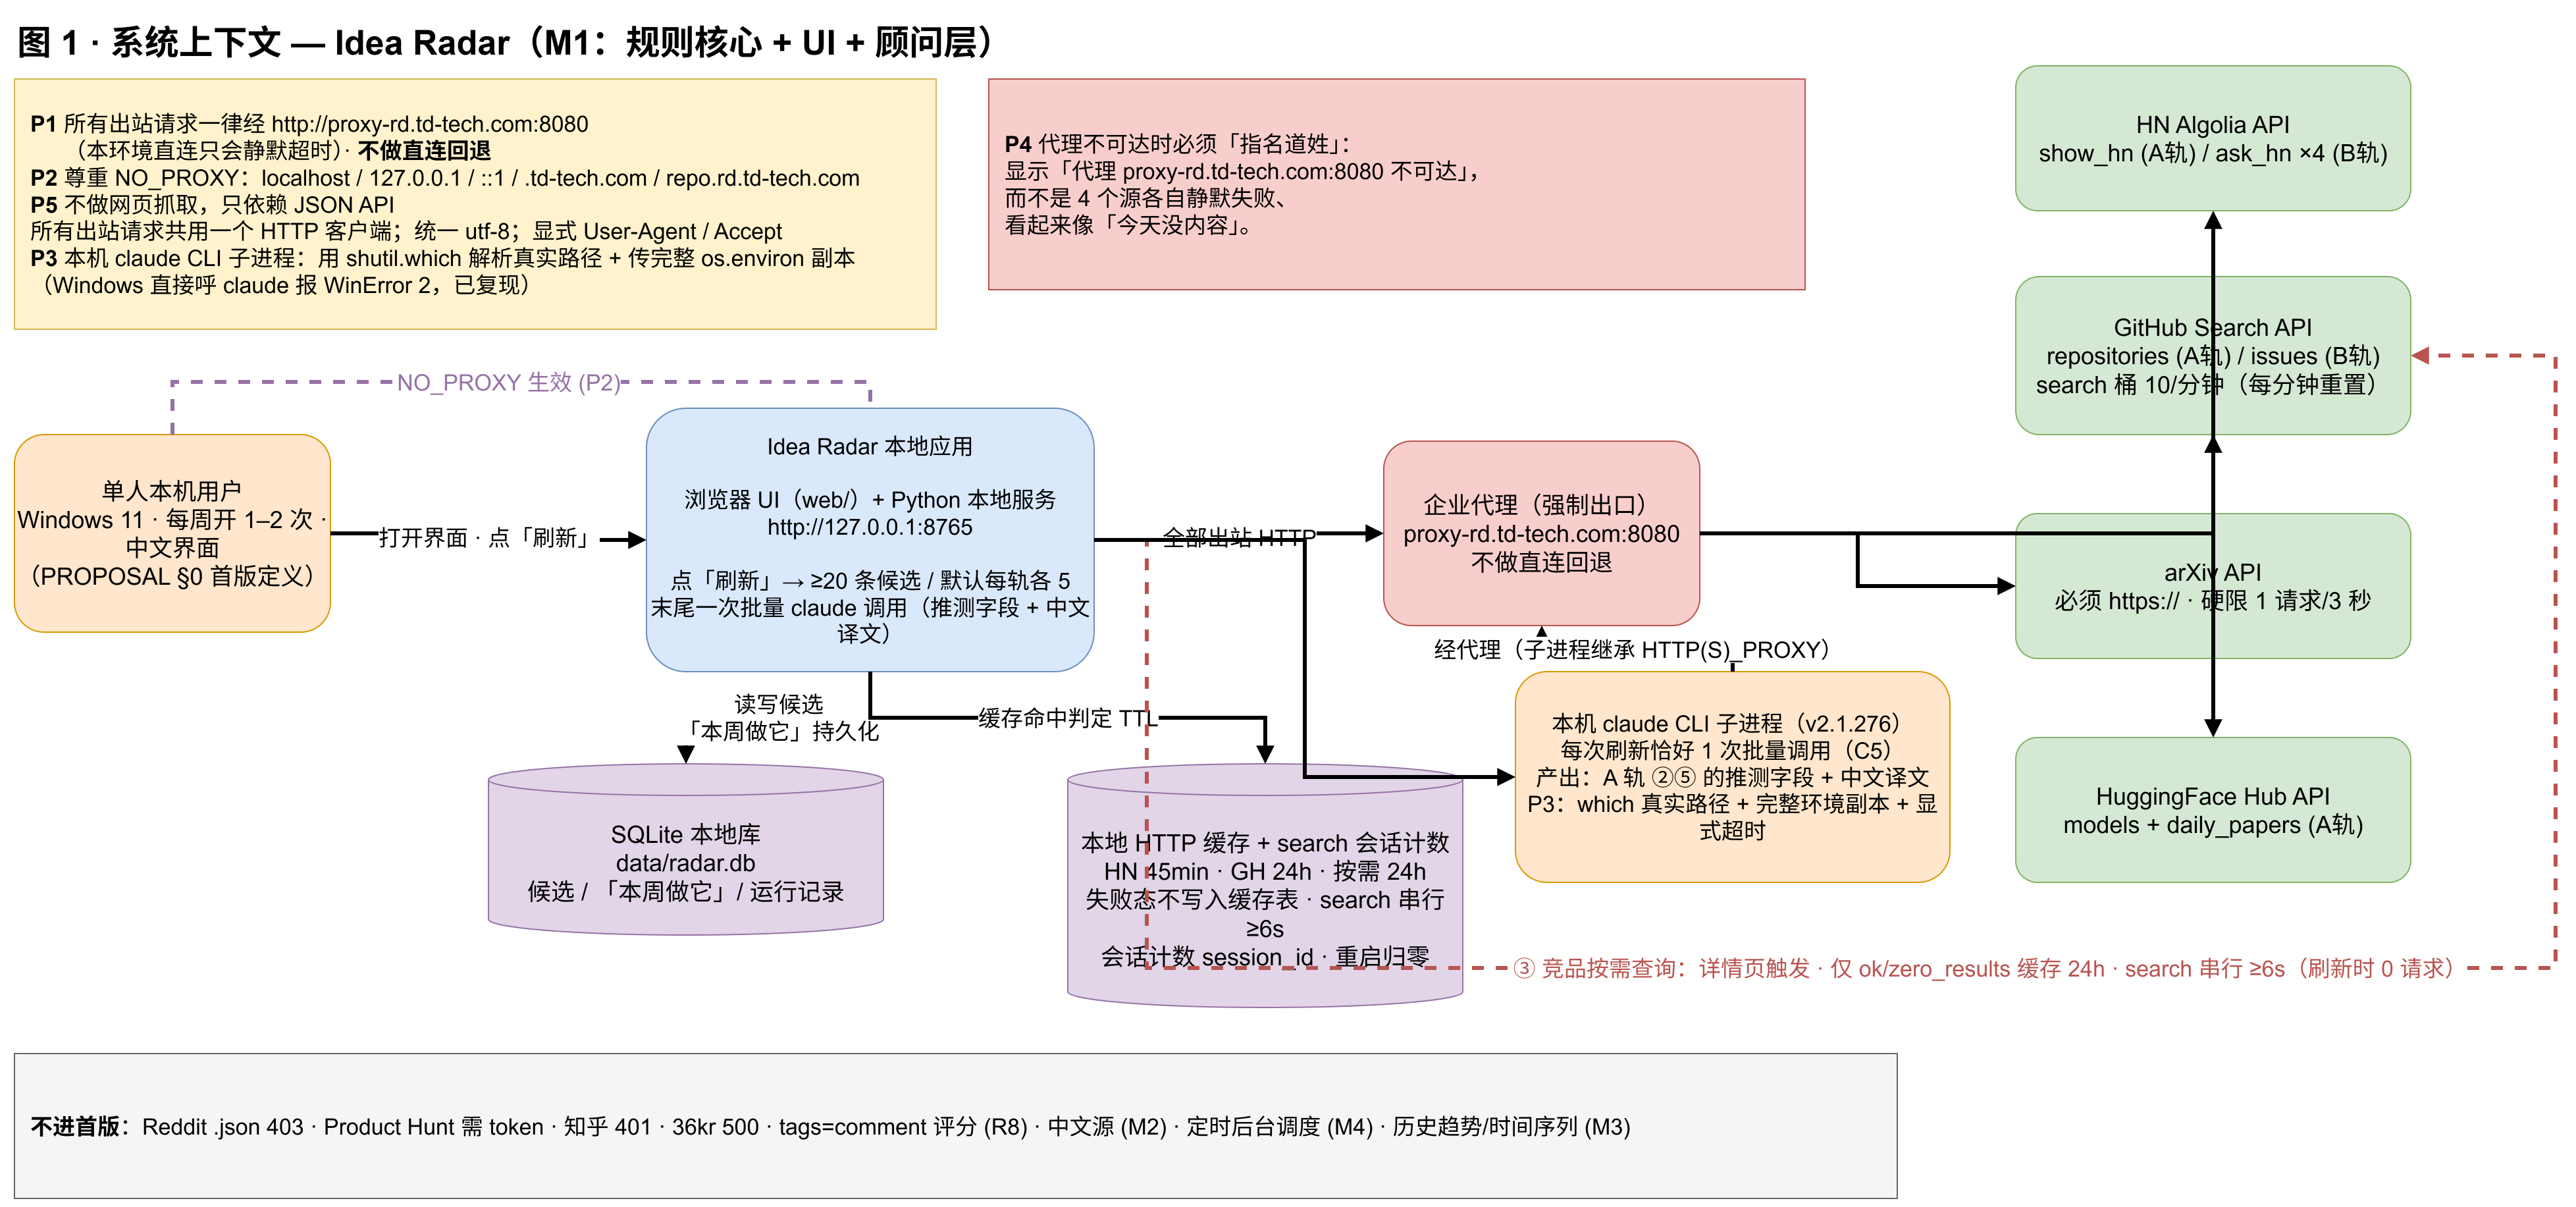
系统组件图
刷新时序图
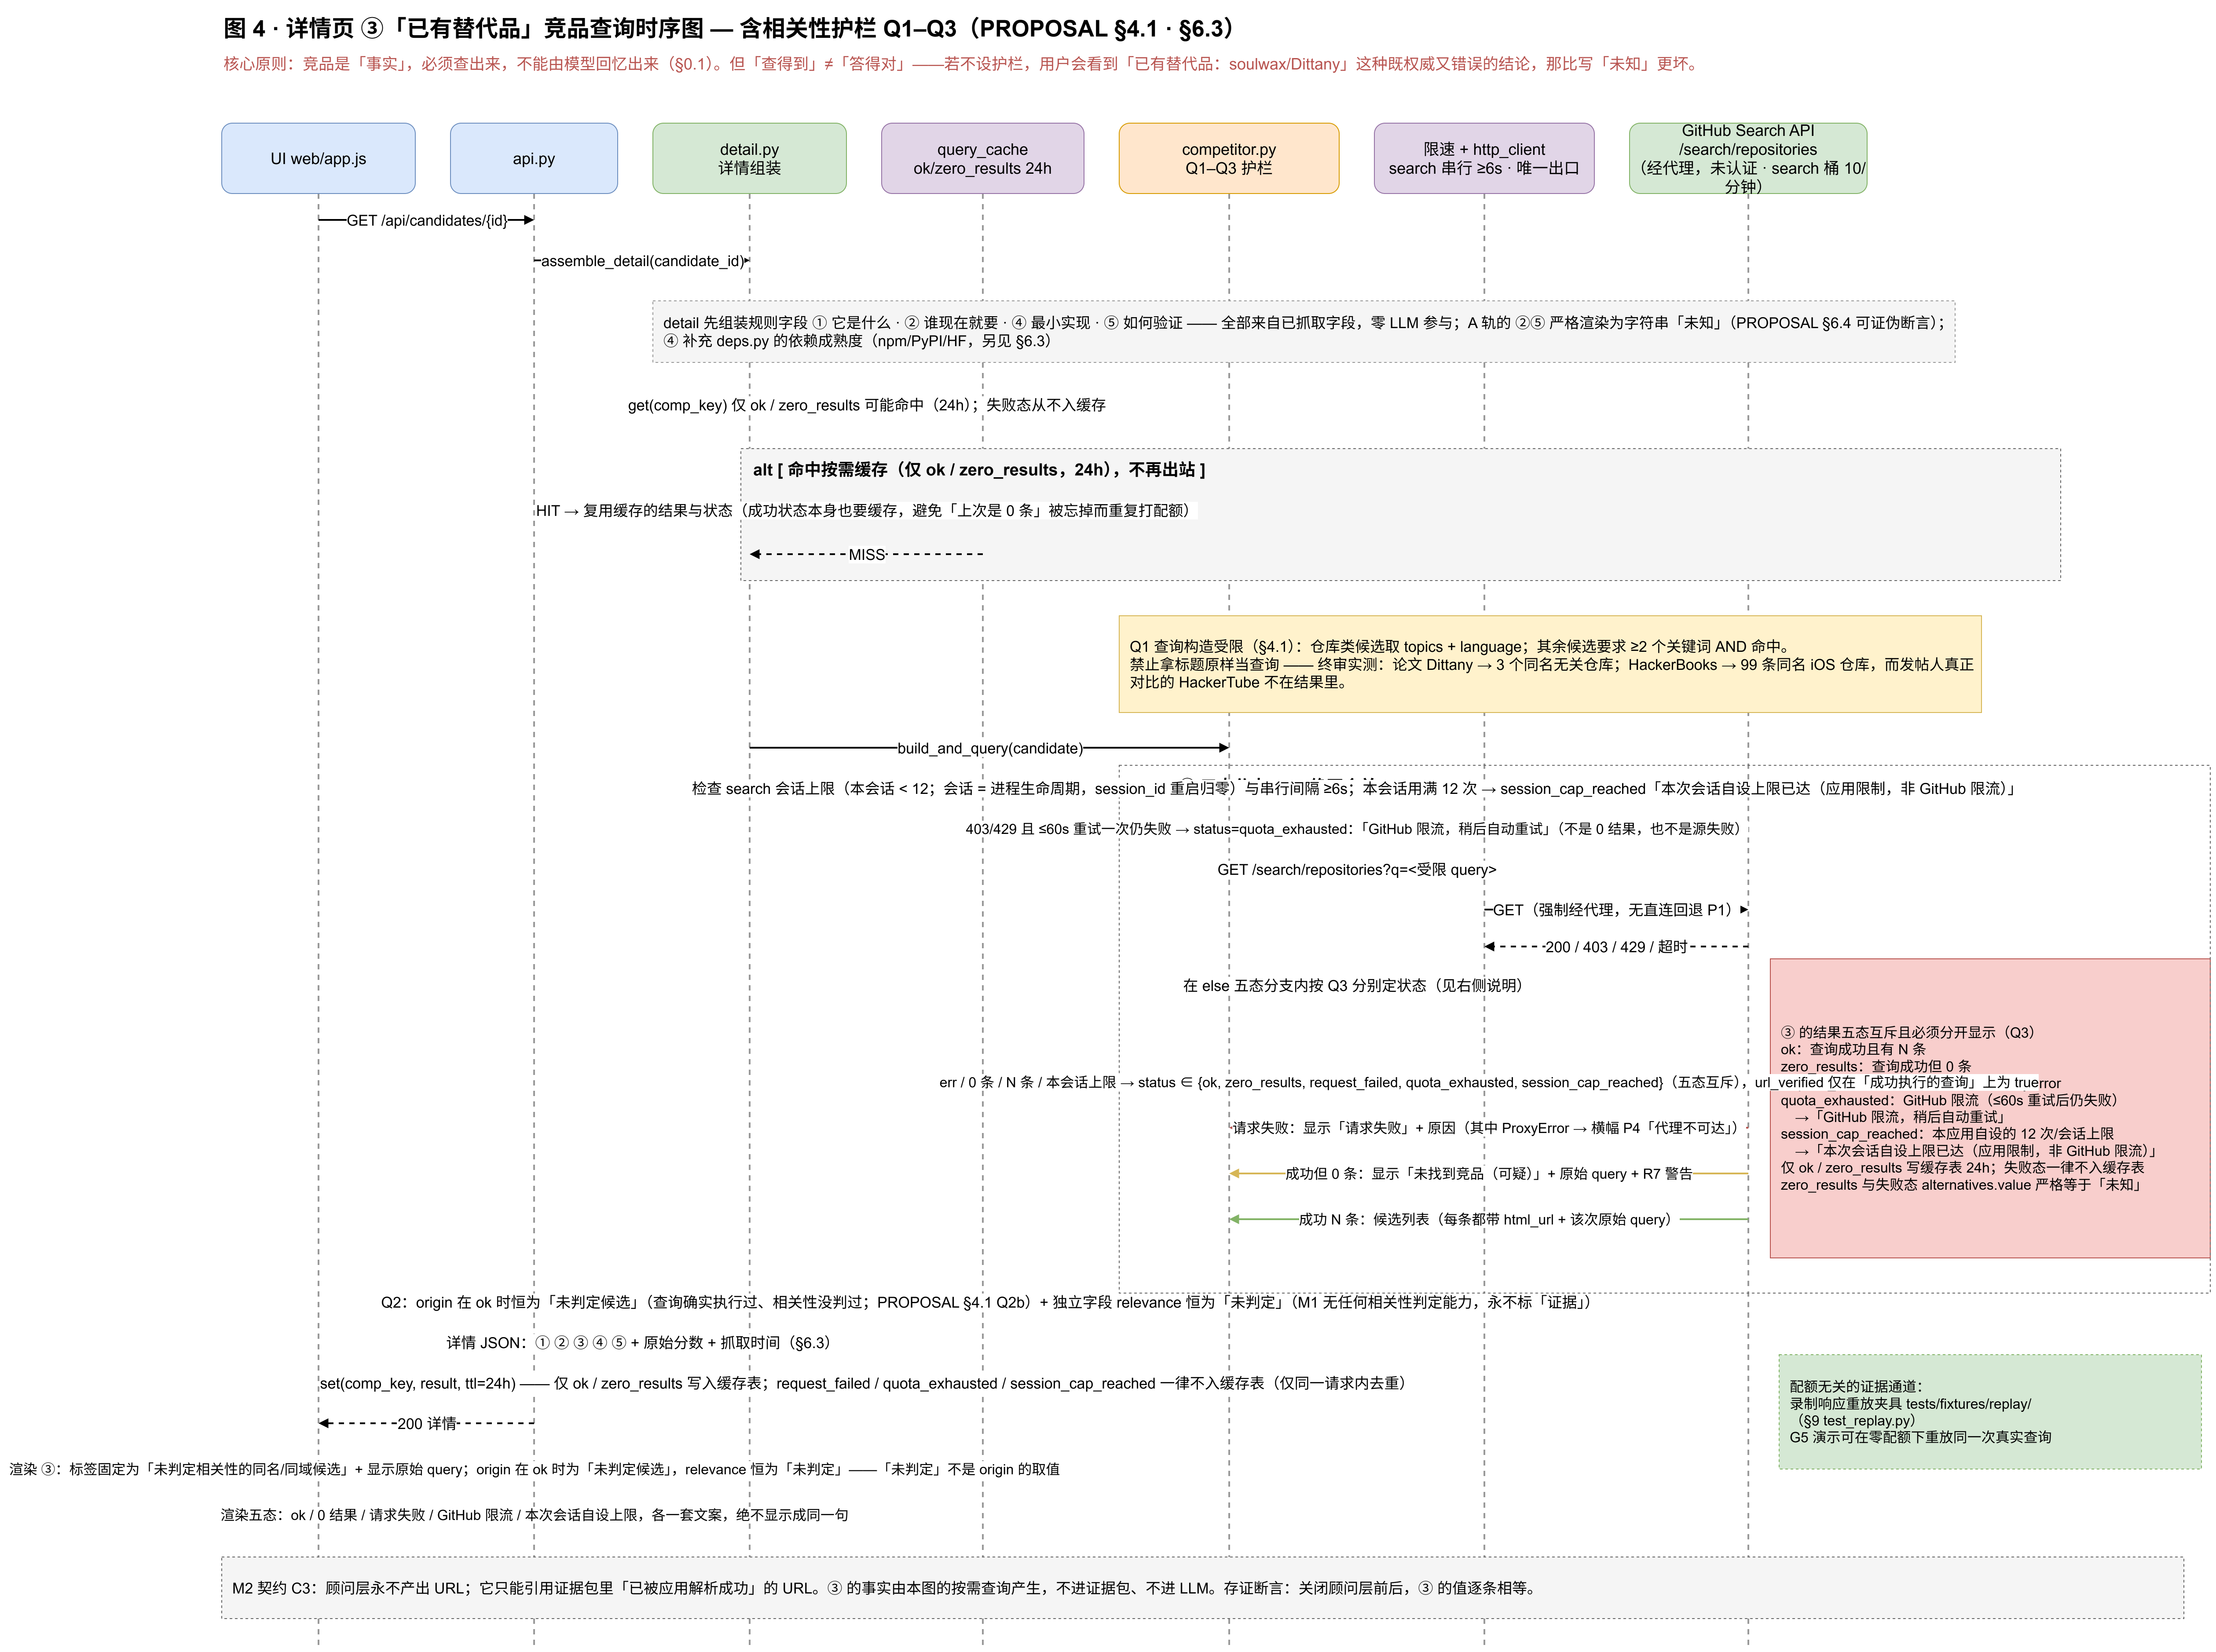
数据模型
G3 界面审批
这个批次的交付物为一个可简单交互的,带静态数据的简单设计稿,html格式交付。具体页面较多,大致如下:
列表页面
详情页面
G4 开发计划审批
基本没啥好批的,本质上就是AI基于当前架构,整理了一份相互依赖关系,先推进被依赖的再推进依赖项,大概率不需要人工干预,直接配准执行即可,大致内容如下:
需要你决定的事: 批准这份开发计划、授权开始写代码吗?
我的建议: 批准。过了这道闸,我就进入无人值守的构建循环,只在 G5(版本交付) 时再来找你。
你要批的是什么(2 分钟能看完)
3 个里程碑 / 22 个任务;M1 详细到 20 个任务,最少的并行批次是 10 批(这是依赖 + 文件双重强制的链长下界,不是排期疏忽)。
M1 的推进顺序(每批可并行的任务用 · 分隔):
1 | b1 T1 顾问层成本实测 spike ← 先打掉成本假设,唯一无依赖的任务 |
G5 — Idea Radar 本地单人版(v0.1.0)
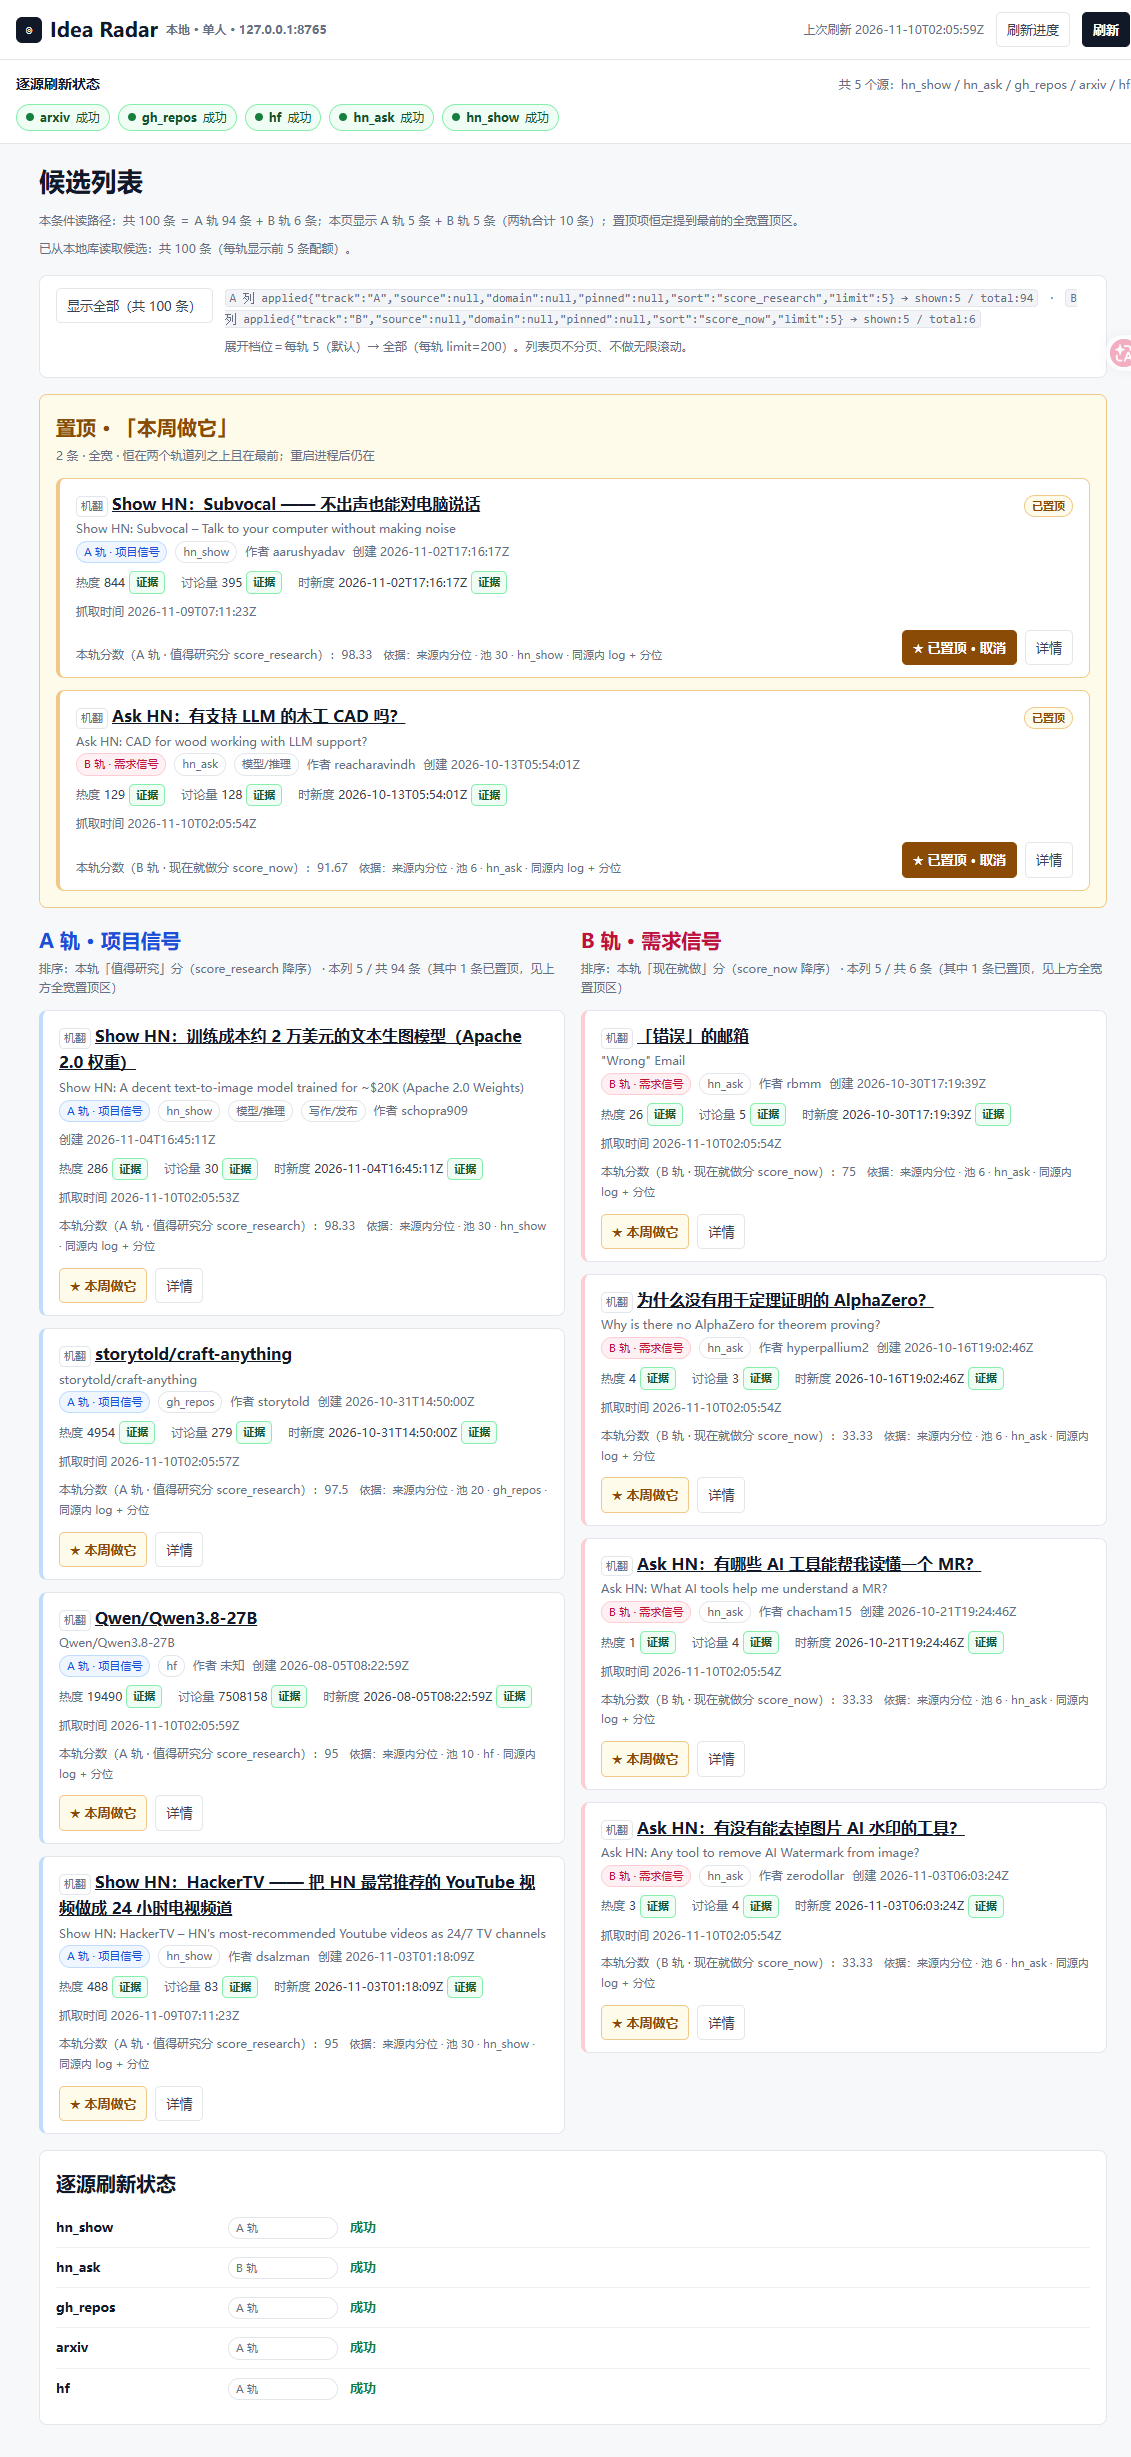
到此阶段AI将完整项目落地了,
Idea-ForgeSkill的使命结束,人工可以交互执行,判定是否达到预期,有何功能需要调整。之后算是进入迭代期,可以基于Vibe或者Spec工作流基于个人喜好继续迭代。 具体截图如下:
总结
到最后总想说几句与开发无关的话,Idea-Forge与Idea-Radar 都是将Token转化成价值的工具和过程。而工具和过程普遍不重要。真正重要的是可沉淀对新时代,新工具的认知,可积累的现实意义上的现金流和物理财富。
Token就相当于新时代的汽油,单位时间内能消耗多少汽油,是由自身引擎的功率决定的,而自身引擎的转化率决定了实际的有效产出。
现在汽油不要钱,那就疯狂改造自身引擎吧,提升功率和转化率,持续运转别爆缸就行。
越来越感觉人脑的算力低、上下文短、注意力窗口窄、能耗高,保养费用高,也就高阶抽象和联想能力是现阶段的人工智能无法比较的,但感觉也不了多久也会被人工智能超越,相必到时也快强人工智能了吧。